


챗GPT 글에 자꾸 나오는 '—' 기호, 진짜 AI 티일까? AI 모델별로 세어 봤더니 7.4개 vs 0개 (결과 표·한국어 글 AI 티 점검표·고치는 요청문)


챗GPT로 쓴 글을 보면 유독 자주 나오는 기호가 있습니다. 문장 중간에 툭 들어가는 긴 가로줄 "—", 이름은 엠 대시(em dash)예요. 영어권에서는 "엠 대시가 보이면 AI가 쓴 글"이라는 말이 밈처럼 돌 정도입니다.
그런데 이번에 AI 평가 기관 아티피셜 애널리시스(Artificial Analysis, AA)가 실제로 AI 모델들이 이 기호를 얼마나 쓰는지 세어 봤습니다. 결과가 꽤 재밌어요. 답변 하나에 7번 넘게 쓰는 모델이 있는가 하면, 40번 답해도 한 번 안 쓰는 모델도 있었습니다. 같은 회사 모델끼리도 극과 극이었고요.
이 글에서는 조사 결과를 한국어로 정리하고, 리포트·자소서·메일을 AI로 쓸 때 "AI 티"가 나는 표시들을 어떻게 점검하고 고치는지까지 복사해 쓰는 요청문과 함께 다룹니다.
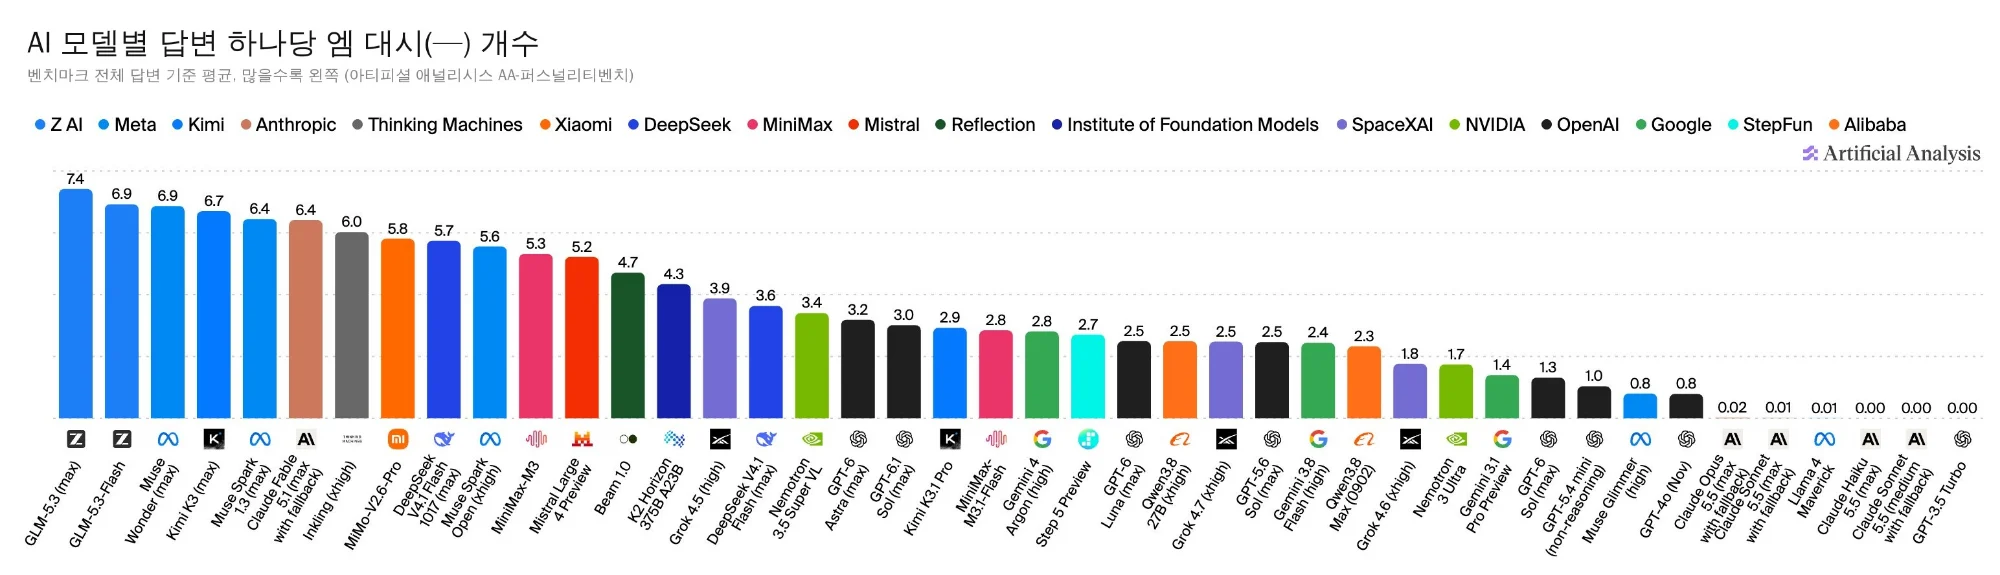
아티피셜 애널리시스가 공개한 AA-퍼스널리티벤치 엠 대시 집계 차트(제목 한국어 번역). 왼쪽일수록 많이 씁니다.
1. 엠 대시가 뭔데요?
| 기호 | 이름 | 길이 | 주로 쓰는 곳 |
|---|---|---|---|
| - | 하이픈 | 가장 짧음 | 단어 잇기(예: e-mail), 전화번호 |
| – | 엔 대시 | 중간 | 범위 표시(예: 2024–2026) |
| — | 엠 대시 | 가장 김(알파벳 M 너비) | 문장 중간에 설명 끼워 넣기, 화제 전환, 강조 |
영어 예문으로 보면 "AI is powerful—but not perfect"처럼 두 덩어리를 이어 주는 역할이에요. 원래 사람도 쓰는 정상적인 문장부호입니다. 다만 한국어 글에서는 원래 거의 안 쓰는 기호라서, 한국어 답변에 섞여 나오면 오히려 더 눈에 띕니다.
2. 어떻게 조사했나요
- 조사 이름: AA-퍼스널리티벤치(AA-PersonalityBench)
- 방식: 30가지 성격·문체 특성과 관련된 질문 900개에 각 모델이 답하게 함
- 조건: 별도 지시(시스템 프롬프트) 없이 같은 질문만 던져서 모델의 "기본 글버릇"을 비교
- 측정: 답변 속 문장부호, 문장 길이, 목록, 이모지 사용 빈도 등. 이번에 공개한 건 그중 엠 대시 개수
- AA의 설명: 우열을 매기려는 게 아니라 모델마다 의사소통 방식이 어떻게 다른지 보여 주려는 것. 엠 대시를 많이 쓴다고 글을 잘 쓰거나 못 쓴다는 뜻은 아님
3. 결과 한눈에 보기
가장 많이 쓴 모델
| 순위 | 모델(회사) | 답변당 평균 |
|---|---|---|
| 1 | GLM-5.3 (Z.ai, 중국) | 7.4개 |
| 2 | GLM-5.3 플래시 (Z.ai) | 6.9개 |
| 2 | 뮤즈 원더 (메타) | 6.9개 |
| 4 | 키미 K3 (문샷, 중국) | 6.7개 |
| 5 | 뮤즈 스파크 1.3 (메타) | 6.4개 |
| 5 | 클로드 페이블 5.1 (앤트로픽) | 6.4개 |
우리가 많이 쓰는 서비스 쪽은?
| 회사 | 모델 | 답변당 평균 |
|---|---|---|
| 오픈AI(챗GPT) | GPT-6 아스트라 | 3.2개 |
| 오픈AI | GPT-6.1 솔 | 3.0개 |
| 오픈AI | GPT-6 루나 / GPT-5.6 솔 | 각 2.5개 |
| 오픈AI | GPT-6 솔 | 1.3개 |
| 오픈AI | GPT-4o(11월판) | 0.8개 |
| 오픈AI | GPT-3.5 터보(2023년 초기 챗GPT) | 0.00개 |
| 구글(제미나이) | 제미나이 4 아르곤 | 2.8개 |
| 구글 | 제미나이 3.8 플래시 | 2.4개 |
| 구글 | 제미나이 3.1 프로 프리뷰 | 1.4개 |
| xAI(그록) | 그록 4.5 / 4.7 / 4.6 | 3.9 / 2.5 / 1.8개 |
| 딥시크 | V4.1 플래시 | 5.7개(설정에 따라 3.6개) |
| 앤트로픽(클로드) | 클로드 오퍼스 5.5 | 0.02개 |
| 앤트로픽 | 클로드 소네트 5.5 | 0.01개 이하 |
| 앤트로픽 | 클로드 하이쿠 5.5 | 0.00개 |
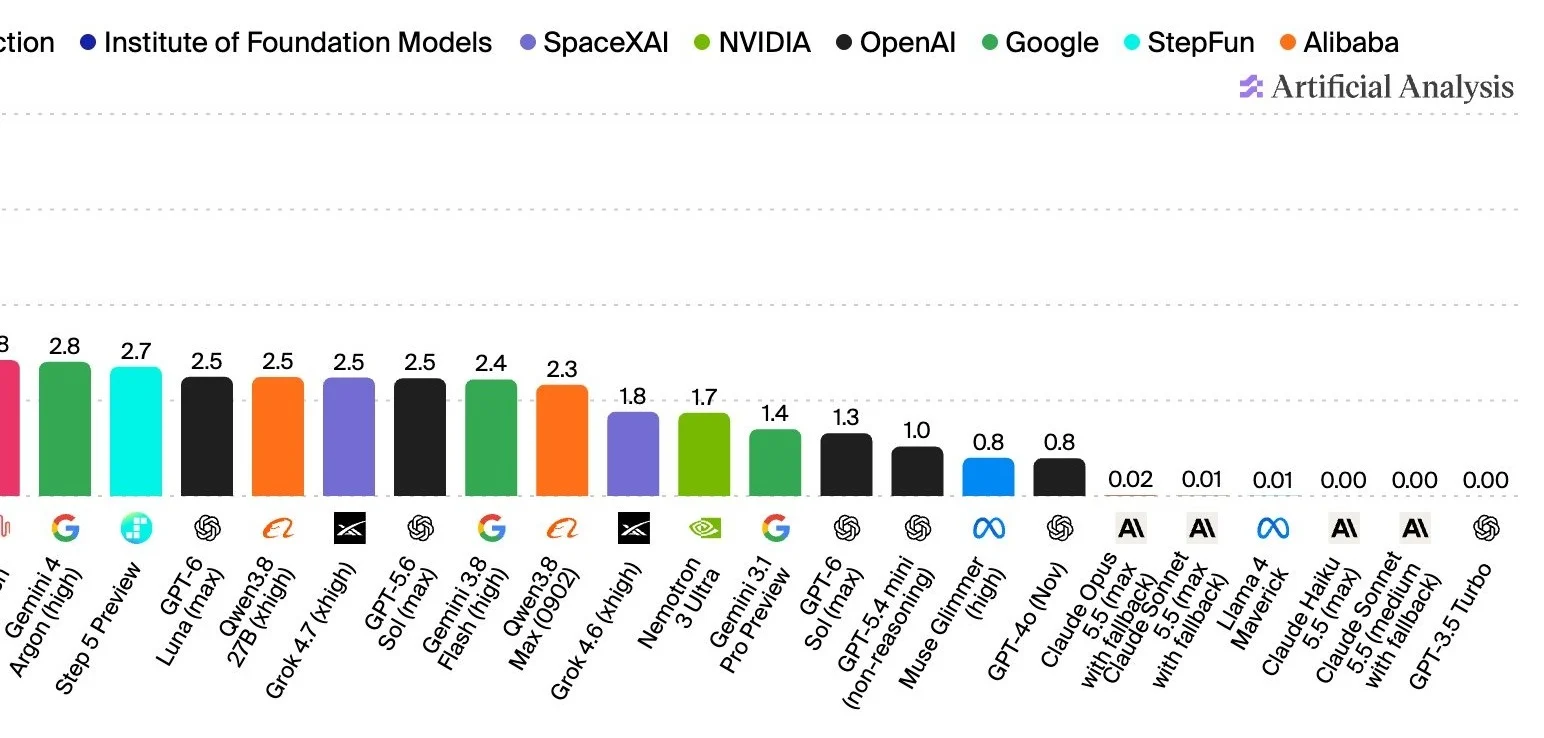
같은 차트의 오른쪽 부분. 챗GPT·제미나이 모델들이 2~3개 안팎, 클로드 5.5 계열과 GPT-3.5 터보가 0에 가깝습니다.
눈여겨볼 점 세 가지
- 같은 회사라도 모델마다 완전히 다릅니다. 클로드 오퍼스 5.5는 답변 40개에 하나 나올까 말까인데, 같은 앤트로픽의 클로드 페이블 5.1은 6.4개로 상위권이에요.
- 초기 챗GPT는 거의 안 썼습니다. "챗GPT = 엠 대시"라는 인식과 달리 2023년 GPT-3.5 터보는 0.00개. 이후 모델에서 늘어난 겁니다.
- AI타임스는 이를 두고 문장부호 습관이 회사보다 개별 모델의 학습·조정 방식에 따라 달라진다는 걸 보여 준다고 정리했습니다.
4. 그럼 엠 대시 있으면 AI 글인가요?
아닙니다. 이건 꼭 짚고 가야 해요.
- 엠 대시는 사람 작가와 기자도 널리 쓰는 정상적인 기호입니다. 기호 하나로 AI 여부를 판별할 수 없다는 게 기사와 AA 모두의 설명이에요.
- 반대로 엠 대시가 없다고 사람이 쓴 글이라는 보장도 없습니다. 위 표처럼 거의 안 쓰는 모델도 많으니까요.
- 친구나 동료 글에 "—" 있다고 "너 AI 썼지?" 하는 건 근거가 약합니다.
다만 내가 AI 도움을 받아 쓴 글을 내 목소리로 다듬고 싶을 때는 이런 글버릇을 아는 게 꽤 유용합니다. 아래부터는 그 방법이에요.
5. 한국어 글에서 흔히 보이는 "AI 티" 점검표
엠 대시 말고도 AI 초안에 자주 남는 버릇들이 있습니다. 제출 전에 한 번 훑어보세요.
| 점검 항목 | 이런 게 보이면 | 고치는 방향 |
|---|---|---|
| 긴 줄표 "—" | 문장 중간에 "—"가 반복 | 쉼표, 괄호, 문장 나누기로 바꾸기 |
| 굵은 글씨 남발 | 문단마다 강조 | 꼭 필요한 한두 곳만 |
| 기계적인 목록 | 모든 내용이 3개짜리 글머리표 | 문단으로 풀어 쓰기 |
| 뻔한 마무리 | "결론적으로", "~하는 것이 중요합니다" | 내 생각이나 구체적 사례로 끝내기 |
| 과한 균형 맞추기 | "장점도 있지만 단점도 있습니다"의 반복 | 내 입장을 분명히 |
| 구체성 부족 | 숫자·날짜·경험 없이 일반론만 | 실제 경험, 수업 내용, 출처 숫자 넣기 |
| 어색한 번역투 | " | 평소 말하듯 바꾸기 |
6. 바로 쓰는 요청문
챗GPT, 제미나이, 클로드 어디서든 그대로 복사해서 쓰면 됩니다.
① 처음부터 줄표 없이 쓰게 하기
앞으로 답할 때 긴 줄표(—)와 엔 대시(–)는 쓰지 마.
쉼표나 괄호, 짧은 문장으로 나눠서 써 줘.
굵은 글씨와 글머리표 목록도 꼭 필요할 때만 써.
② 이미 쓴 글 점검받기
아래 글에서 AI가 쓴 것처럼 보일 만한 표현을 찾아서 표로 정리해 줘.
(긴 줄표, 반복되는 접속어, 뻔한 마무리 문장, 번역투 등)
각 항목마다 원래 문장과 자연스럽게 고친 문장을 나란히 보여 줘.
내용은 바꾸지 말고 표현만 고쳐.

(여기에 글 붙여넣기)
③ 내 말투로 바꾸기
아래는 내가 평소에 쓴 글이야. 이 말투와 문장 길이를 참고해서
그다음에 붙인 초안을 내가 쓴 것처럼 다시 써 줘.
줄표(—)는 쓰지 말고, 내가 안 쓰는 어려운 단어도 빼 줘.

[내가 쓴 글]
(붙여넣기)

[고칠 초안]
(붙여넣기)
④ 메일·카톡용으로 짧게
아래 내용을 직장 상사에게 보내는 짧은 메일로 써 줘.
3문장 이내, 줄표나 목록 없이, 사람이 직접 쓴 것처럼 담백하게.

(내용 붙여넣기)
워드·한글에서 한 번에 찾아 지우기
- MS 워드: Ctrl+H(맥은 Cmd+Shift+H) → 찾을 내용에 "—" 붙여넣기 → 바꿀 내용에 ", " 또는 공백 → 모두 바꾸기
- 한글(HWP): Ctrl+H 찾아 바꾸기 → 같은 방법
- 구글 문서: Ctrl+H → 같은 방법
모두 바꾸기 후에는 문장이 어색해진 곳이 없는지 꼭 한 번 읽어 보세요.
7. 주의할 점
- 학교·회사 규칙이 먼저입니다. AI 사용을 금지하거나 표기하라는 과제라면 표현을 다듬는 것과 별개로 규칙을 지켜야 해요. 이 글은 AI 사용을 숨기는 방법이 아니라 글을 자연스럽게 다듬는 방법입니다.
- AI 탐지기는 정확하지 않습니다. 기호나 말투 몇 가지로 판정하는 방식은 사람 글을 AI 글로 잘못 보는 경우도 생깁니다.
- 이번 조사는 별도 지시 없이 영어 질문에 답한 기본값 기준입니다. 위 요청문처럼 지시를 주면 대부분 모델이 줄표를 줄일 수 있어요.
- 모델 이름 옆 (max), (high) 같은 표시는 생각을 얼마나 깊게 하게 했는지 같은 설정 차이입니다. 같은 모델이라도 설정에 따라 수치가 달라질 수 있어요(딥시크 V4.1 플래시가 5.7개와 3.6개로 두 번 나온 것처럼).
8. 자주 묻는 질문
Q. 내가 쓰는 챗GPT는 어떤 모델이에요? A. 앱 상단이나 모델 선택 메뉴에서 확인할 수 있습니다. 위 표의 GPT-6 계열은 2.5~3.2개, 예전 GPT-4o는 0.8개였어요.
Q. 한국어로 물어봐도 줄표가 나오나요? A. 이번 조사는 한국어 기준이 아니라서 수치로 말하긴 어렵습니다. 한국어는 원래 줄표를 거의 안 쓰는 글이라, 나오면 더 눈에 띈다는 정도로만 기억하면 됩니다.
Q. 클로드는 왜 거의 안 쓰나요? A. AA나 앤트로픽이 이유를 밝히지는 않았습니다. 다만 같은 회사의 클로드 페이블 5.1은 많이 써서, 회사 방침이라기보다 모델별 학습·조정 차이로 보는 해석이 나옵니다.
Q. 줄표 말고 다른 항목 결과도 나오나요? A. AA는 문장 길이, 목록, 이모지 등도 함께 분석했다고 밝혔습니다. 이번에 따로 공개된 건 엠 대시 집계예요.
Q. 줄표만 지우면 자연스러워지나요? A. 아니요. 5번 점검표처럼 뻔한 마무리, 일반론, 번역투를 같이 고쳐야 내 글처럼 읽힙니다. 가장 효과가 큰 건 내 경험과 구체적인 숫자를 넣는 거예요.
9. 정리
"엠 대시 = AI"는 반만 맞는 이야기였습니다. 많이 쓰는 모델은 답변 하나에 7번 넘게 쓰지만, 클로드 5.5 계열이나 초기 챗GPT처럼 거의 안 쓰는 모델도 있어요. 기호 하나로 남의 글을 의심하기보다는, AI 도움을 받은 내 글을 제출하기 전에 줄표·뻔한 마무리·일반론을 한 번씩 걷어 내는 습관이 훨씬 쓸모 있습니다.
출처
- 아티피셜 애널리시스 X 게시물, AA-퍼스널리티벤치 엠 대시 집계(2026.11.4)
- AI타임스, "중국 GLM-5.3, 답변마다 '엠 대시' 7.4개 사용…클로드는 거의 안 써"(2026.11.5)
- 이미지: 아티피셜 애널리시스 공개 차트(제목 한국어 번역)
아직 ‘도움돼요’를 누른 회원이 없어요. 어떤 직업에 도움이 됐는지 여기에 모여요.
댓글 [0]
로그인하고 경험을 나눠 주세요. 서로 다른 직업의 시선이 큰 도움이 됩니다.
로그인하고 댓글 쓰기아직 댓글이 없어요. 첫 댓글을 남겨 주세요.